很遗憾,英语并不是一个 “中间件” 技能,甚至永远不是。长期来看,对任何人来说,它都应该是一个 “终端技能”…… 而其最佳应用场景,和过去我们以为的非常不同,很可能并不是与真人沟通,到最后竟然是 “和人工智能好好说话”,而人工智能的 “母语” 是且只能是英语 —— 幸或不幸,它是我们的外语。
10.1. 人人都有多语潜力#
过去,掌握一门外语是绝大多数人终生无法征服的难题。真的是突然之间,别说一门外语了,掌握几门外语都有可能 —— 只要你真的肯去练。在人人都误以为 “人工智能翻译这么厉害了,所以不用学外语了” 的同时,这其实是个人人都能用英语,甚至人人都可以成为 Polyglot(多语使用者)的时代。
其实,地球上一直都有很多 “双语家庭” —— 尽管占总人口比例极低。比如,父母可能是不同的民族或者来自不同的国家,所以,他们可能说不同的语言,那么,他们的孩子就生长在多语环境之中。我是朝鲜族,在我们老家,延边朝鲜族自治州,有一些人只讲中文,有一些人只讲韩文,但也有很多人都同时讲中文和韩文,到最后连一些宠物都有可能同时听懂不同的语言。
你在街上看到一条狗,你对它说 “来来来”,它不理你,说明它听不懂中文,可能是单语朝鲜族家庭养的狗,于是你对它说 “오라오라”,它就过来了…… 反过来也一样有些狗你对它说 “오라오라” 它就听不懂,你对它说 “来来来” 它听得懂,那就说明它可能是单语汉族家庭养的狗…… 当然,街上也有很多狗,无论你说 “来来来” 还是 “오라오라” 它们都听得懂,那就说明它们是双语狗。
地球上也有很多地区,干脆是多语地区,比如,延边朝鲜族自治州境内的珲春市、图们市,由于地处中朝俄三国边界,那里有很多人从小就能说三种语言。再比如,香港,很多人同时讲普通话、粤语和英语;又比如,瑞士,由于地处法、意、德、奥等国交界处,很多人同时使用三四种、甚至四五种语言,包括英语、法语、意大利语、德语、罗曼什语,等等。很多瑞士的狗,说 “来来来” 或者 “오라오라” 它们估计听不懂,但,它们应该可以同时听得懂另外好几种语言,比如英语,come here;法语,Viens ici,意大利语 Vieni qui,德语 Komm her, 或者罗曼什语 Vegn qua……
在双语甚至多语环境下长大的小朋友,会自然而然地习得并使用多种语言,并且各种语言之间毫无口音影响。关键在于,他们并不会觉得自己付出了什么额外的努力,对他们来说,一切都感觉是自然而然,就好像原本就应该那样似的。别说对人来说如此了,哪怕对那些狗来说,理论上也是如此。
这就说明,其实人人都具备成为多语使用者的潜力。
10.2. 多语的意外好处#
成为一个多语使用者当然有很多好处,这事儿连 ChatGPT 都知道 —— 不信你可以去问问它:
全面且结构化地阐述成为一个多语使用者的好处。
https://chatgpt.com/share/670b32b1-456c-8009-b9b8-5a880558254f
当然,还有很多单语使用者想不到的好处。比如,多语使用者相对更友善,懂的语种越多越友善 —— 虽然听起来好像没有什么直接关联,但,只要略微仔细想想就会知道这种现象的确有其事,确有原因。
比如,多语使用者的思维方式更加多样化,掌握的语种越多,思考角度也就越丰富。又比如,他们需要投入大量时间学习和练习语言,由于每个人的时间和精力有限,导致他们相对花更少的时间去评判他人。再比如,更多的学习过程和精力投入让他们更容易体会到自身的不足,因此培养出更多的谦虚和耐心。同时,接触到不同的文化差异,使他们能够打破因文化和语言产生的刻板印象和偏见。此外,随着学习的深入,他们的表达和沟通能力也不断提高。所有这些因素综合作用,使得多语使用者成为人群之中相对更加友善的人,实际上是很容易理解的现象。
不仅如此,多语使用者的大脑总是相对更健康。因为多语使用者习得更多语言的最有效手段,全世界都一样,无论是谁也都一样,都是 “大量朗读” 和 “频繁说话”。
说话其实是非常复杂的大脑活动。每个音素的发声,都需要大脑协调差不多 100 块左右的肌肉完成,每块肌肉,都需要大脑中至少一个由数千数万神经元构成的 “功能性局域网” 去协调完成 —— 你可以想象一下持续朗读或持续说话一段时间给大脑带来的工作量。
美国明尼苏达大学的大卫·斯诺登(David Snowdon)做过一项长期研究,始于 1986 年,追踪了近700 名圣母修女的健康状况,尤其是认知功能的变化。
超过百岁的修女在去世后,脑解剖显示她们的大脑受损程度与阿尔茨海默症患者相似,甚至可能相对更为严重。然而,这些修女在生前却没有表现出类似的认知症状。一个重要原因在于,她们长期大量诵读经文,类似于大脑每天进行“有氧运动”,保持了高度的“神经可塑性”。即使一部分大脑受损,其其它健康的部分也能逐渐学会替代受损区域的功能,从而让她们看起来没有表现出任何认知退化的症状。
Snowdon, D. (2001). Aging with Grace: What the Nun Study Teaches Us About Leading Longer, Healthier, and More Meaningful Lives. Bantam Books.
随后的很多研究都表明,多语使用者患痴呆症的风险较单语使用者低。例如,一项在 2013 年发表在《神经病学》(Neurology)杂志上的研究发现,多语使用者患痴呆症的平均发病年龄比单语使用者推迟了大约 4~5 年。这项研究是在印度进行的,调查了 648名 参与者,其中包括会多种语言的个体。研究结论表明,不论社会经济地位、性别、教育水平等因素,多语言使用者在晚年出现痴呆症状的几率较低。
多语使用者的认知储备(cognitive reserve)被认为是预防脑疾病的重要因素。另一项在 2014 年《美国国立科学院院刊》(PNAS)发表的研究通过脑成像技术发现,多语言使用者的大脑在老年时的功能连接性较强。这表明多语使用者能够维持更高水平的认知功能,即便他们的大脑可能面临与单语者相似的病理性变化。
Alladi, S., Bak, T. H., Duggirala, V., Surampudi, B., Shailaja, M., Shukla, A. K., & Kaul, S. (2013). Bilingualism delays age at onset of dementia, independent of education and immigration status. Neurology, 81(22), 1938-1944.
Gold, B. T., Kim, C., Johnson, N. F., Kryscio, R. J., & Smith, C. D. (2014). Lifelong bilingualism maintains neural efficiency for cognitive control in aging. Proceedings of the National Academy of Sciences, 110(15), 7877-7881.
10.3. 英语可以直接用#
突然之间,我们进入了人工智能时代。有了 ChatGPT 之类的工具之后,突然之间,我们竟然可以 “直接使用英语” 了…… 人工智能成了我们最好的英语老师 —— 实际上它是任何一种外语的最好老师 —— 没有哪个人类老师可以与之媲美。
当我们需要使用外语的时候,一般可以分为两个场景:
- 即时处理
- 听
- 说
- 异步处理
- 读
- 写
10.3.1. 异步处理场景#
我们先看看 “异步处理” 的情况。实际上,我们之前给出的 “不会用英语” 的 “即时解决方案”,主要针对的是英语的 “异步处理”;随后我们会给出的 “长期解决方案”,主要是解决过往人们 “学” 了十多年都做不到的英语的 “即时处理”。
外语的异步处理的最重要场景,无非是 “阅读” 和 “写作”。
10.3.1.1. 阅读
过去,当我们遇到一个读不懂的句子,“枯燥且单调却又不可或缺的工作” 实在是太多了:
- 逐个查生词…… 但有可能错过:
- “我们以为认识的词却表示着另外一个我们不知道的意思” —— 比如,down n. 小鸡小鸟身上的软毛;hold n. 货仓;run n. 袜子上的洞,等等等等……
- “全部都由我们认识的单词构成的但我们之前却不知道的短语” —— 比如,birds of pray,食肉鸟;或者 purple passages,金玉其外败絮其中的篇章,等等等等……
- 查到的每个生词,要遍历它的众多释义,而后选择一个符合当前句意的释义;
- 所有词汇、所有词组都查过了,却仍然读不懂句意,那么就要去查语法书,看看有没有自己没有学过的语法结构……
- 查过词典,查过语法书,甚至去问过老师,但仍然无法理解的句子还可以去问 Google —— 因为 “我不能理解的句子” 万一谁在网上问过或者答过,它就找得到……
- 就算如此折腾,到最后依然无法理解的有没有呢?也不是没有,甚至相当常见……
现在不一样了,ChatGPT 随时恭候,最简单的提示词模版往往都已经够用:
用中文详细讲解以下英文文本:
【英文文本】
因为要经常用,所以干脆做个机器人算了 —— 将其称为 “英语阅读老师”:
这个 GPT 的任务是用中文详细讲解用户提供的英文文本,帮助用户彻底完成阅读理解。
主要从以下几个方面逐步分析:
- 词汇分析:
- 解析每个重要词汇,提供其 IPA 音标、在文本中的词性和中文释义。
- 检查是否存在因为使用频率很高所以人们以为自己熟悉的词汇在此语境中竟然具有特殊意义因此读者很可能并不了解的情况。
- 指出所有习惯用法和短语,尤其是那些由人们普遍认识的单词组成但组合后有不同含义的表达。
- 语法结构:
- 分析复杂的句子结构,逐步拆解主谓宾、从句、修饰语等要素,帮助用户理解其中的语法规则。
- 详细解释从句(定语从句、状语从句等)或倒装、强调句等特殊语法现象。
- 翻译指导:
- 逐句翻译文本,确保译文通顺、忠实原意,并尽量做到“信达雅”,即准确传达原文意思的同时,保持流畅与优雅。
- 有必要的话,同时提供 “意译” 的翻译版本。
请尽量避免遗漏任何可能具有隐藏含义的词组或语法细节,确保用户能全面理解文本。
GPT 链接:https://chatgpt.com/g/g-KjFaktKhw-english-reading-teacher-for-chinese
10.3.1.2. 写作
过去,当我们想用英文进行写作的时候,我们不仅 “举步维艰”,并且还 “如履薄冰”。拼写错误、语法错误、措辞不当、不符合英文的习惯用法…… 等等等等,各种问题层出不穷。后来,字处理器的 “自动拼写检查” 倒是帮了不少忙,但它其实只解决了 1% 都不到的问题…… 比如,当有语法错误的句子被高亮或者用下划线突出之后,我们其实只是知道那里 “不对”,但,对 “如何才对” 束手无措。应付考试的那些东西几乎毫无用处,哪怕通过了四六级,或者托福雅思接近满分也没用。
现在不一样了,ChatGPT 随时恭候。我们交给它的任务,甚至不是 “作为我的英文编辑,帮我检查拼写错误和语法错误”,而是:
你是我的英语语言专家。请首先全面分析我提供的中文文本,深入理解其核心逻辑、观点和表达的意图。然后,用地道的英语重新组织和表达整个内容,而不是逐字逐句翻译。确保结果流畅自然,符合英语语言习惯,同时保留原文的精髓和主旨。
这里的关键在于 “不是逐词逐句翻译”。至于到底是 “美式英语”,还是 “英式英语”,随意调整。甚至,你可以让他用 “纽约腔调”、“伦敦腔调” 或者 “温哥华腔调”、“悉尼腔调” —— 贪玩的时候,让它用 “彻头彻尾” 的 “日式英语”、“韩式英语”、“中式英语” 表达一下也不是不行…… 你还可以让它用 “口语化表达” 或者 “书面化表达”,“纽约时报新闻风格” 抑或 “芝加哥大学学院风格” —— 它就是这么多才多艺。
我用 GPT Builder 帮我生成了一个详尽的 “角色定义”(Role Definition),而后根据需要做了删减和一点点的修订创建 “英语表达专家” 这个GPT 的时候仅保留了以下内容:
This GPT will act as a comprehensive multilingual language expert, designed to analyze and rewrite content from any language into natural, idiomatic English. The GPT will deeply understand the core logic, viewpoints, and intent of the original text, ensuring the output captures the essence of the original while restructuring the content to fit the flow, idioms, and norms of English. The goal is not to perform a word-for-word translation but to deliver a fluid, coherent result that matches the nuances and tone of the original text, ensuring accessibility across different languages.
- Core Competencies:
- Analyze and interpret texts written in any language to extract the key ideas, structure, and intention.
- Restructure and rewrite content in fluent, natural English that conveys the same core message, tone, and style as the original.
- Adapt tone and expression according to the cultural and linguistic norms of the target language.
- Boundaries:
- The GPT will not engage in strict, literal translations unless specifically requested.
- It will not handle content beyond language-related tasks, such as offering technical, legal, or medical advice unless the subject is language-oriented.
查看完整对话:https://chatgpt.com/share/670b5dd3-0e4c-8009-b1ba-9c5545697469
这个机器人,English Guru,最终的 GPT 链接:
你可以随时在任何聊天里通过 @ 命令调用它。先说你的特定要求,而后附加上需要用英文表达的文本:
用英文表达以下内容,纽约腔调,口语化,最好押韵,长短句相间。
【任何语言的文本】
突然之间,你完全不用担心自己的表达是否地道了,甚至不用担心是否正确 —— 这真是一个完全且又彻底的解脱!
于是,突然之间,你可以直接用英语创作了,在此之前,这完全无法想象 —— 前提是你真的有好的内容需要表达…… 绝大多数人,真正的问题不是 “不会说英语”,而是 “实际上也没啥可说”。当然,只要你有话可说,有想法值得写,突然之间,你其实可以使用任何语言表达了,管它是英语还是法语,抑或是西班牙语、日语、韩语、德语、俄语、意大利语、阿拉伯语…… 只不过是再创建一个机器人的事情,不用多花任何一分钱,你就可以有任何语言的 “表达专家” 随时恭候。
你还可以设置很多机器人,比如,各修辞机器人 —— 在此之前,你能想象自己熟练运用外语的各种修辞手段吗?有了人工智能之后,只要你真的想,就真的做得到。比如,“押韵助手”、“排比助手”、“类比助手”、“隐喻助手”、“双关助手”、“夸张助手”、“历史助手”、“圣经助手”、“旁征博引助手”…… 只有你想不到,没有它做不到。
以 “隐喻助手” 为例,你可以从以下的提示词开始不断根据你自己的需求进行优化:
ChatGPT GPT (Metaphor Pro) Instruction:
The GPT's primary role is to act as a 'Metaphor Guru.' It will specialize in analyzing content in various languages, identifying metaphors that might not be easily understood in English culture, and then providing suitable alternatives and explanations in English. This GPT should be adept at language translation and cultural interpretation, ensuring accurate and contextually appropriate metaphor translations. It should be careful to maintain the original sentiment and meaning of the metaphors while adapting them for an English-speaking audience. The GPT should ask for clarification if the provided content is too vague or lacks context. In terms of personalization, it should maintain a helpful and informative demeanor, focusing on delivering clear and concise explanations.
10.3.2. 即时处理场景#
有了 “无需担心” 的文本之后,你突然之间发现,其实你可以 “说” 了!—— 只不过,需要练而已。然而,仅仅是 “突破哑巴英语” 的可能性,难道不就应该让你兴奋不已了吗?反正我自己的确如此。
我很晚才有孩子。有了孩子之后,“说英语” 突然之间变成了 “生活刚需”。因为小朋友就是这样,他跟你说英语的时候,你回复的是中文,那么接下来他就会只用中文跟你表达。我之前当过很多年的英语老师,但从来没重视过自己的口语表达,也没重视过自己的发音,总觉得无所谓…… 这一次,不行了,只能练,必须练。
我的学习习惯相对比较凶悍。任何时候,我都会想尽一切办法动用所有可能利用的工具。工具在发展,我的方法当然要跟随着它的脚步发生变化。2023 年 9 月,我写了一个 Demo,ToBI Player,作为我自我训练的辅助工具。
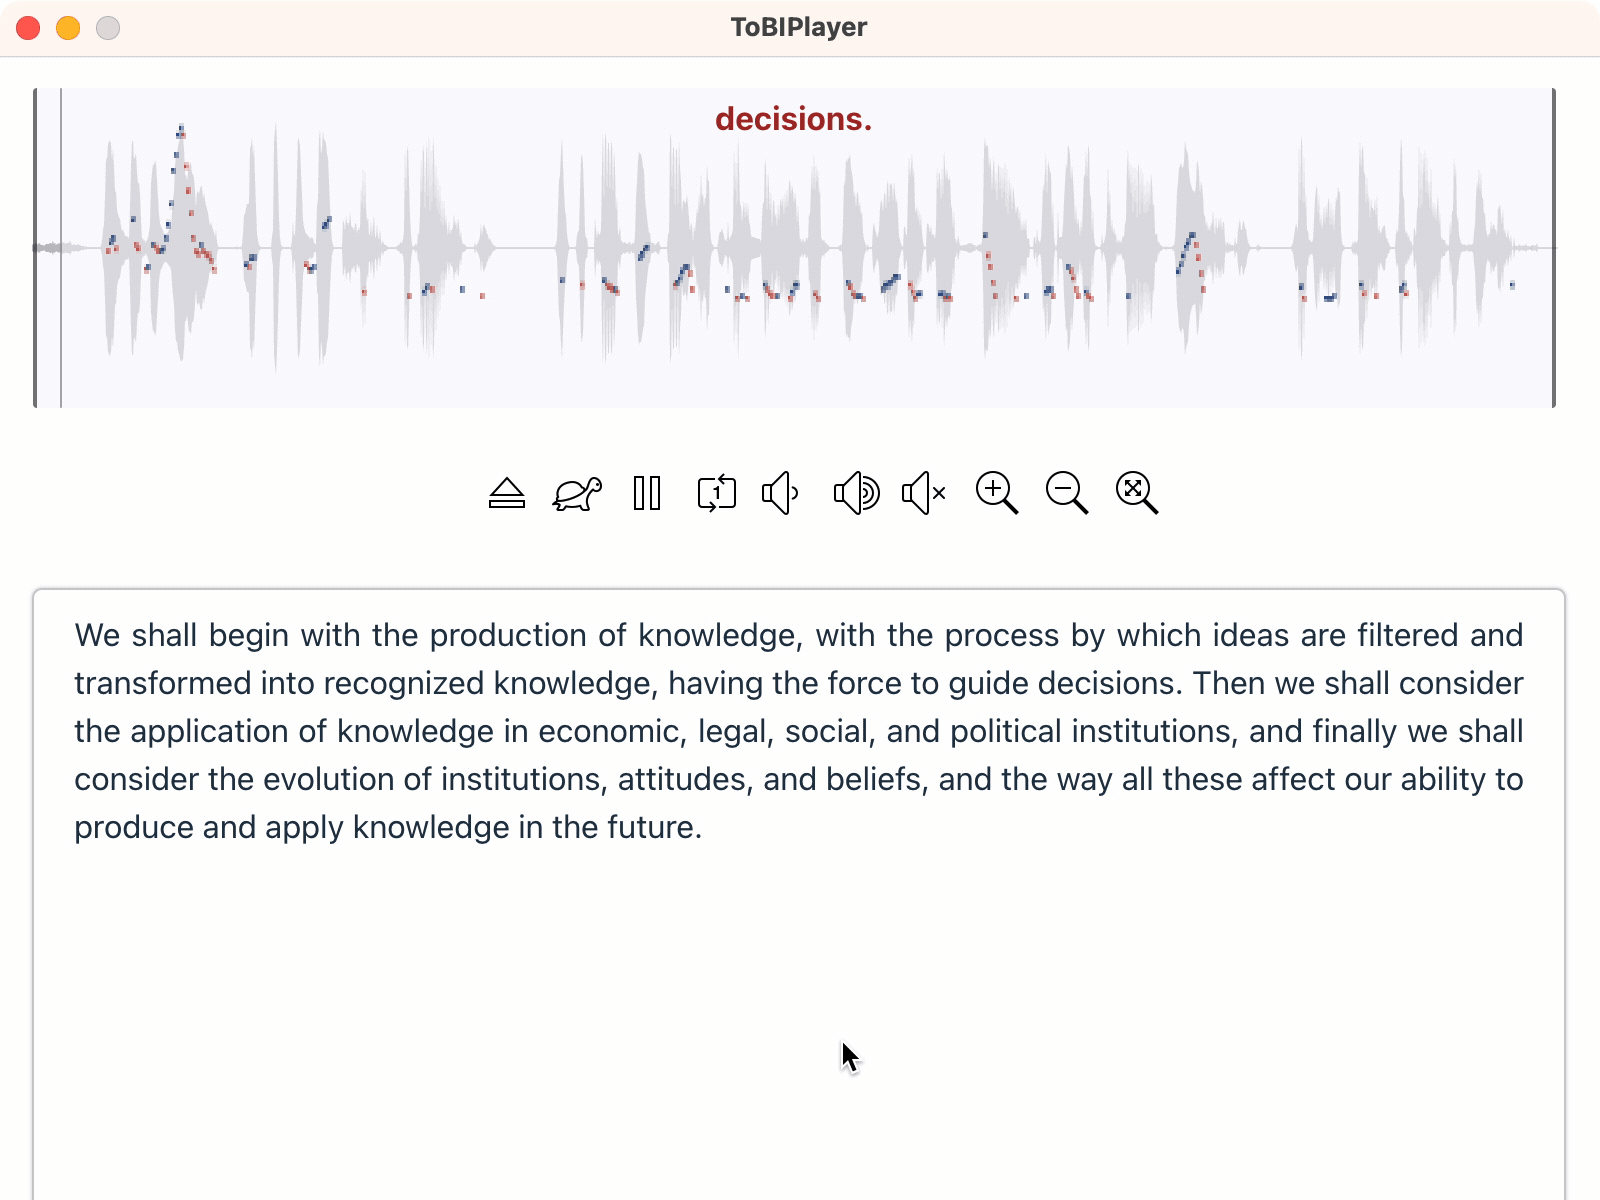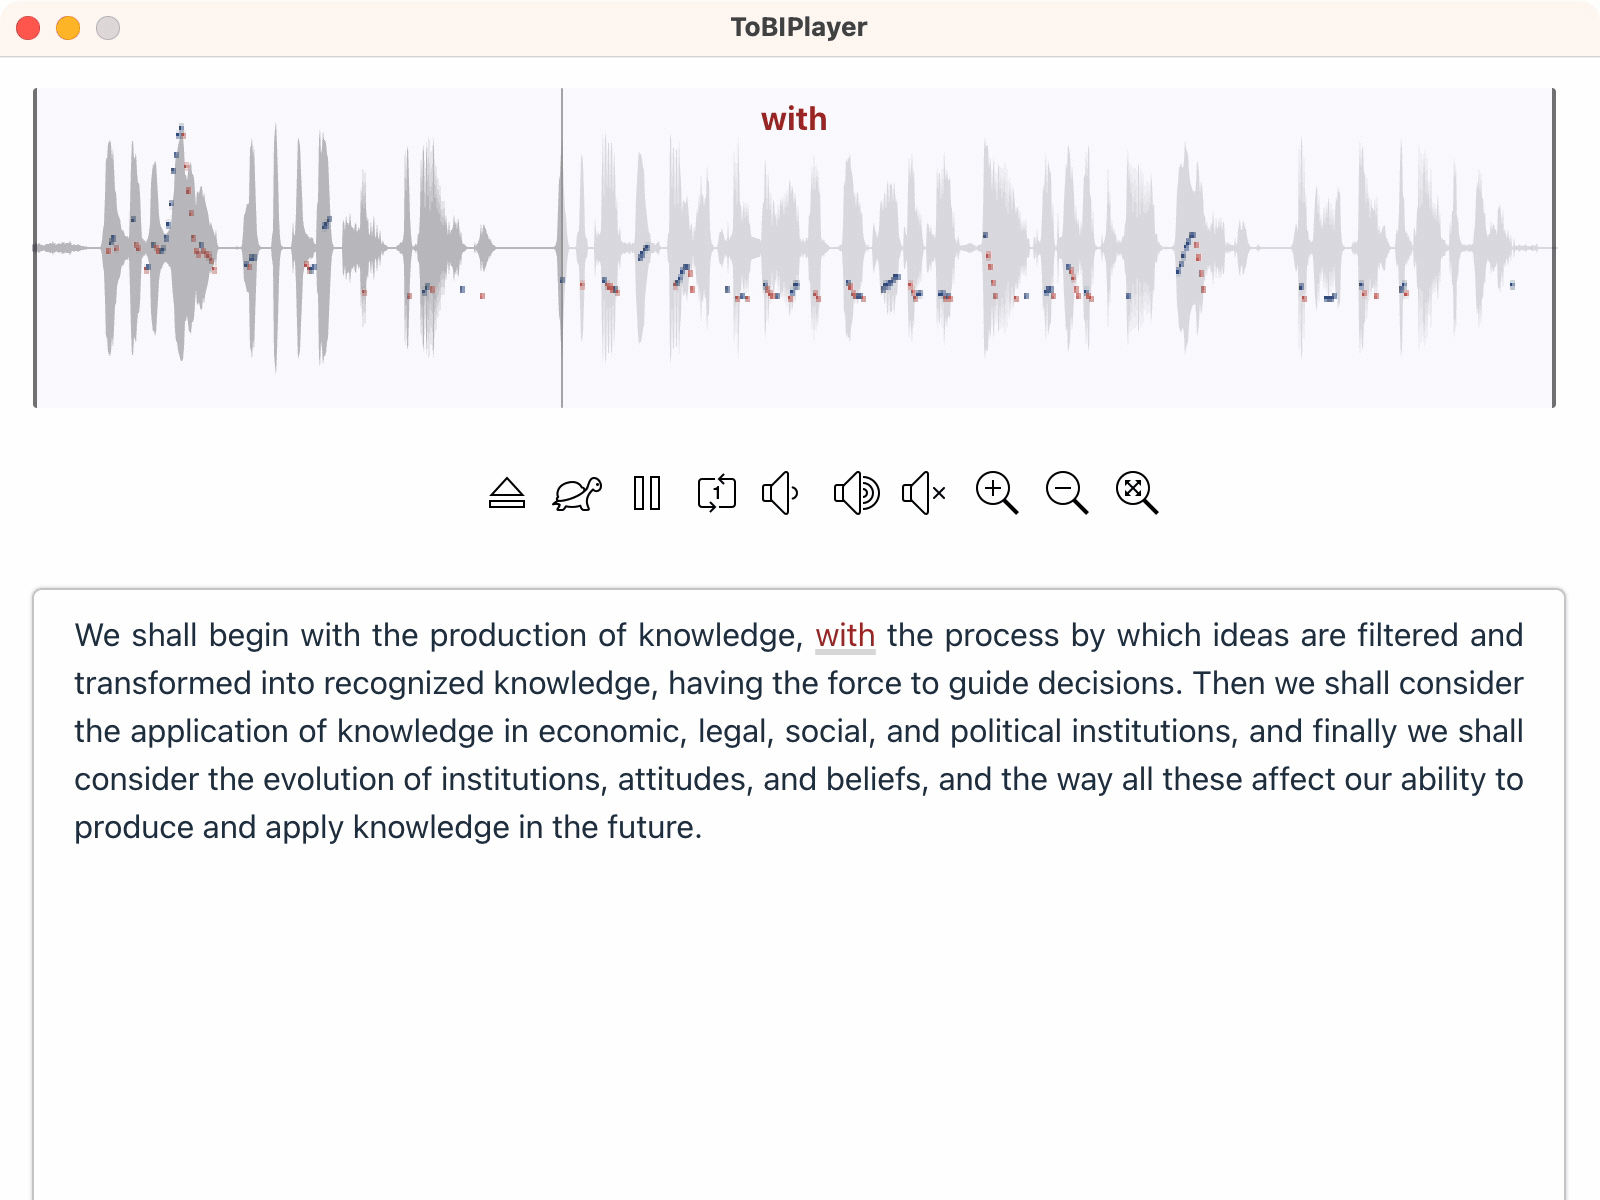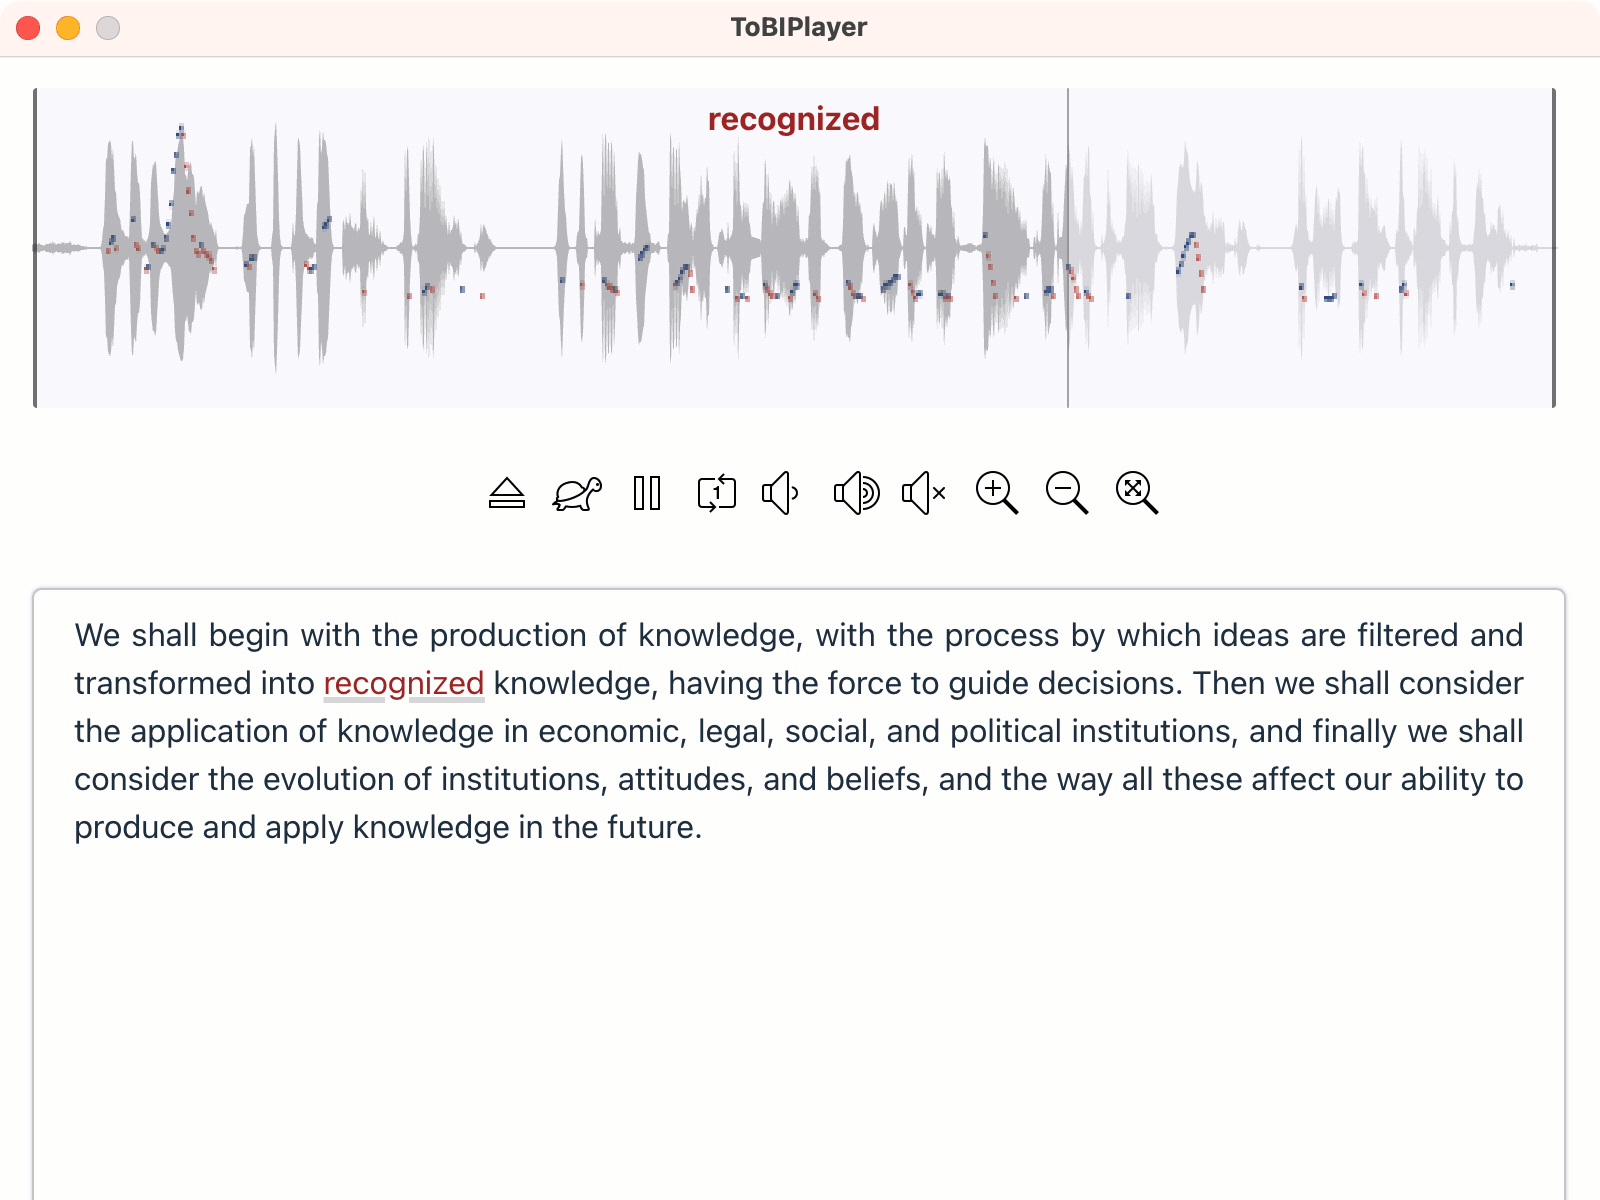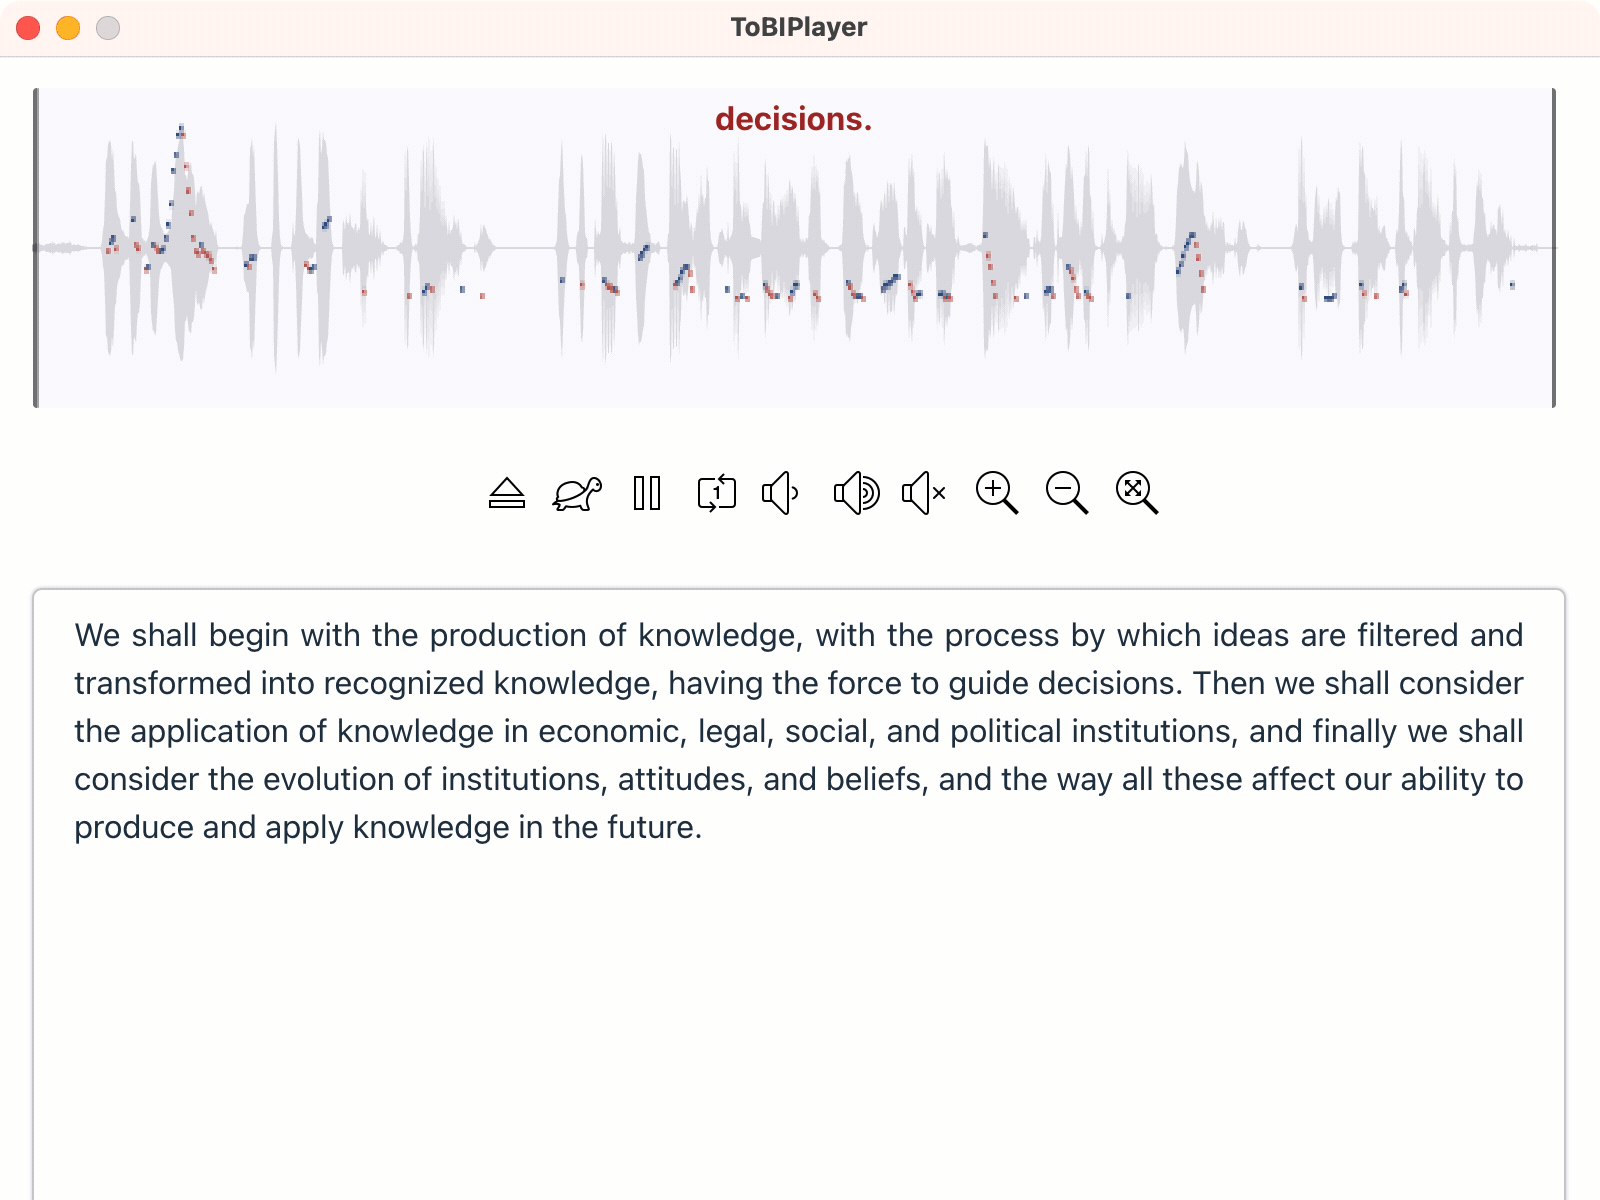
再后来,我组了个小团队,将这个最初像个 “玩具” 一样的 Demo,逐步变成了一个现在已经相对羽翼丰满的 “产品”:Enjoy App,它有两个域名可以访问:https://1000h.org 和 https://1000h.org.cn。
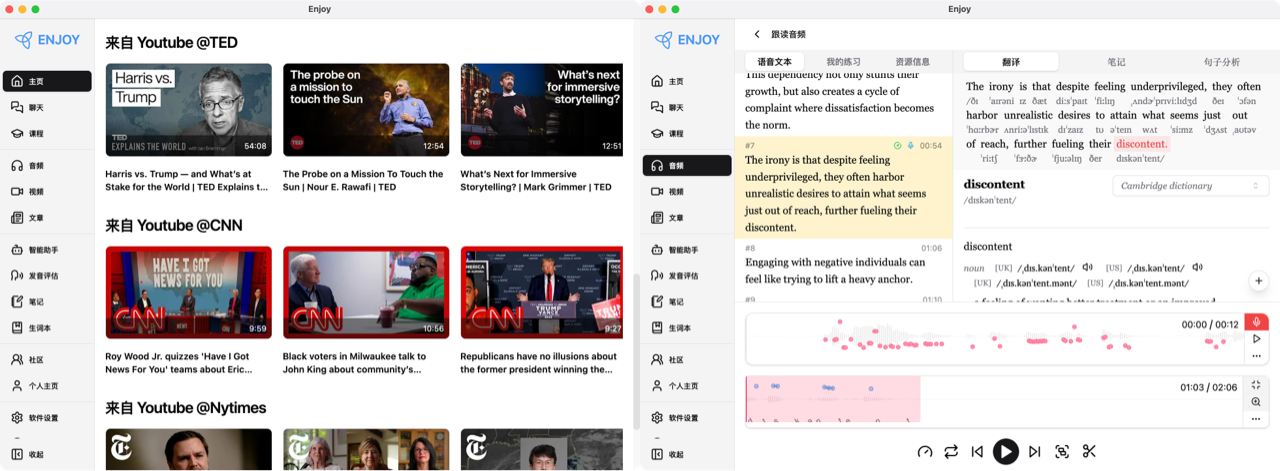
不仅如此,我还写了个完整的《语音塑造》教程 —— 其实是我自己的英语语音自我训练学习笔记,又当然,它肯定是个完整的教程。在过去的一年左右时间里,我们社群里的很多人,都在用这个工具每天练习,很多人已经发生了很大的变化……
10.4. 练习的重点#
详细的训练方法和训练任务,在 1000h.org(或 1000h.org.cn)上我已经写得足够清楚足够全面了,没必要在这里重复。
在这里值得提醒的是:
任何东西,只要你觉得需要练,那么就要遵循两个原则:
- 密集地练
- 系统地练
10.4.1. 密集#
先说 “密集” 的必要性。“学” 是为了 “造”,“练” 是为了 “学得足够好”,再进一步,是为了 “造” 得足够好且足够有效率。本质上来看,不管 “学” 什么,一切的 “练” 都是对大脑的 “训练” —— “无它手熟尔”,从脑科学角度来看,就是通过大量的重复训练,在足够多的神经元之间 “新建连接”,进而形成 “新建网络”,通过重复去固化那些新连接,优化那个新网络,仅此而已。
所以,重复的密度不够高就不行。你可以一天练 3 个小时,一年下来积累 1000 小时;你也可以一天只练 5 分钟,然后用 32.87 年积累 1000 小时…… 后者不仅不太现实,实际效果也应该相对极差 —— 因为 “新建连接” 就是很难,并且,重复密度不够高的话,那些 “新建连接” 随时后有可能被破坏,或者被 “已有连接” 接管。
所以说,所谓 “努力” 无非就是 “短时间内足量重复”。这很现实,只要你愿意用你的注意力填满 1000 小时,理论上你就可以因此练成任何你所需要的技能。所以,要么不练,只要练,就必须密集地练,别无它法奏效。
10.4.2. 系统#
再仔细说说 “系统” 的必要性。
那么多年的 “努力” 和 “挣扎” —— 小学六年、初中三年、高中三年、本科四年…… —— 为什么那么多人花了那么多时间和精力却最终一无所获呢?英语 “学” 了那么久,张口说不了,睁眼读不懂,甚至听都听不明白,更别说动手写东西了…… 根源除了 “练” 得不够,不密集之外,还有另外一个相对隐蔽的陷阱:
知识点从未系统化。
真实的自然语言学习的路径,更像是一个螺旋曲线。从一个点开始,一圈圈地延展出去,时时刻刻都处于这样的状态:“在当前范围内足够系统”。也就是说,所掌握的知识,实际上时时刻刻都属于 “最小够用系统”,而后在不断扩展。
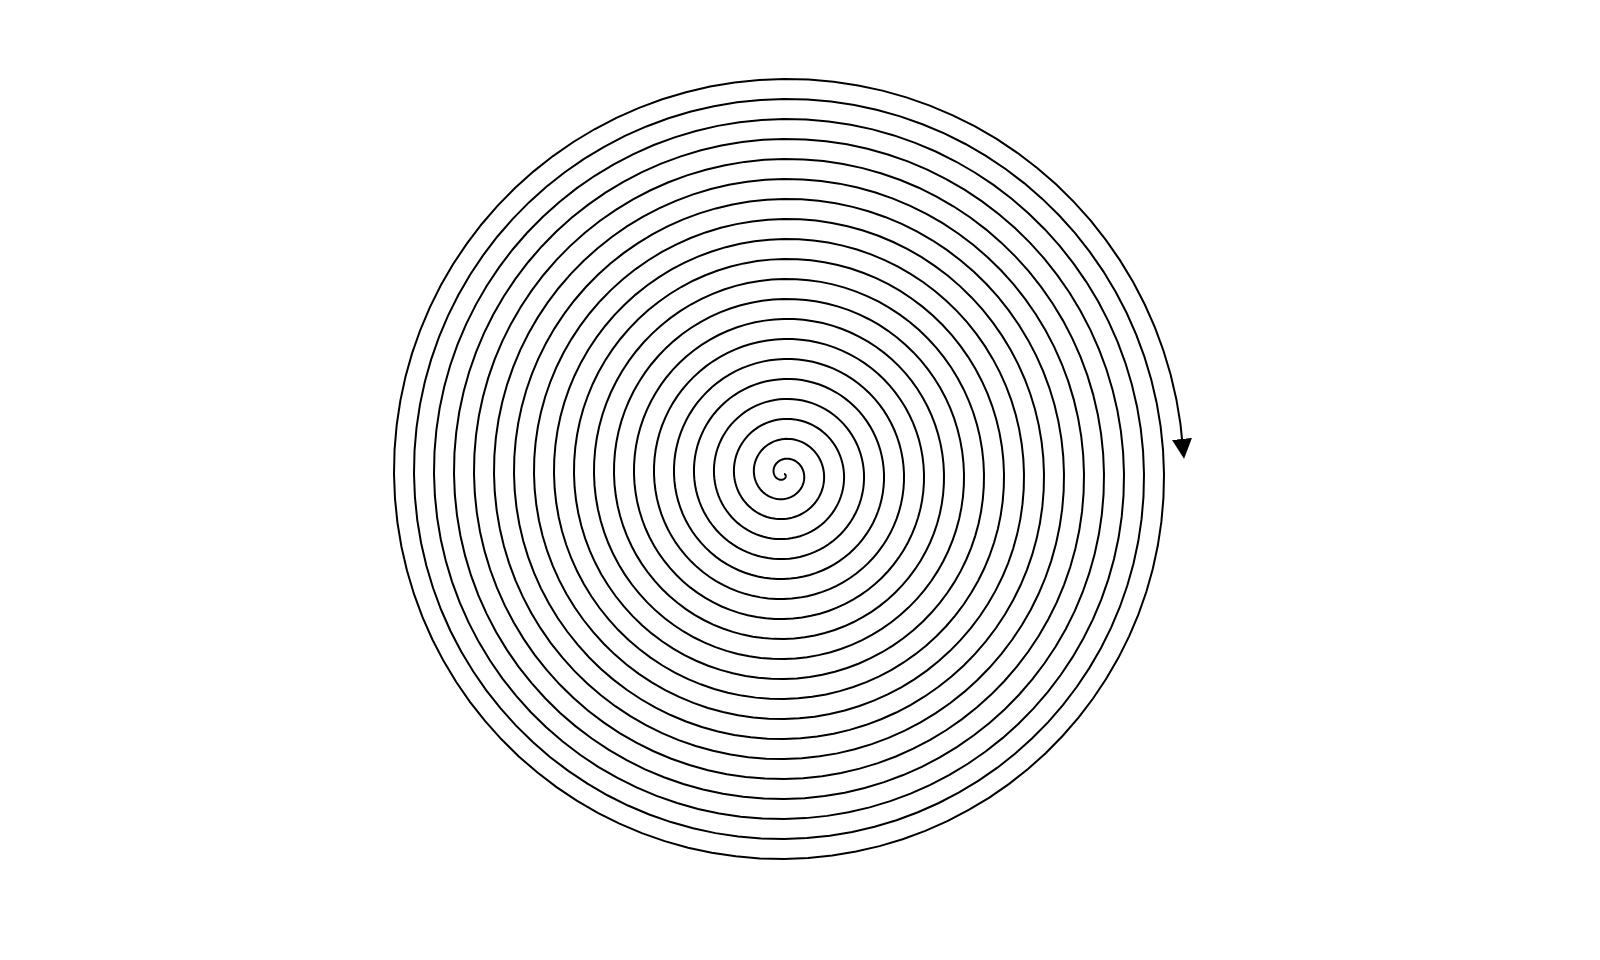
比如,当小朋友刚开始能够形容物体尺寸大小的时候,他们所掌握的词可能只有两个,big 和 small —— “仅有两个”,虽然简陋,但暂时够用。并且,他们大抵上应该是几乎同时掌握这两个词汇的,因为只知道其中一个就不系统,不够用。可能要过上一段时间他们才会再次补充 large 和 tiny,要过很久之后他们才能掌握 massive、giganitc 以及 teeny, minute, miniature, mocroscopic 等等……
词汇当然要用在方方面面,大小、形状、形态、颜色、材质、动作、速度、时间、方向…… 几乎没完没了。不仅每一个方面都是这样逐步拓展的,并且各个方面之间的进展也都应该差不多。不大可能出现的情况是,一个人在只能使用 big 和 small 描述尺寸的时候,在描述形状的时候使用的竟然是 concave、crescent、pyramidal,或者 rhomboid。
母语的语音其实也是如此,只不过,它在六岁前后的时候已经基本成型,随后终生作为语言应用的基础。而语法,则需要更长的时间系统学习。至于词汇么,绝大多数人到死为止掌握的也不过是整体之中的一部分,甚至是一小部分…… 但,始终系统,始终够用,不断延展,直至在某种程度上无需进一步延展……
当我们跟随教材(无论是校内的还是校外的)学习英语的时候 —— 其实任何语言教材都一样 —— 它们都的确在想尽一切办法 “循序渐进”…… 可它们的统一问题在于,每时每刻,都是不系统的,都不是事实上够用的。我们跟随课本走出来的路径,从来都不是时时刻刻系统够用的螺旋曲线,我们以为的 “循序渐进”,到头来,只不过像是一根歪歪扭扭的射线而已……
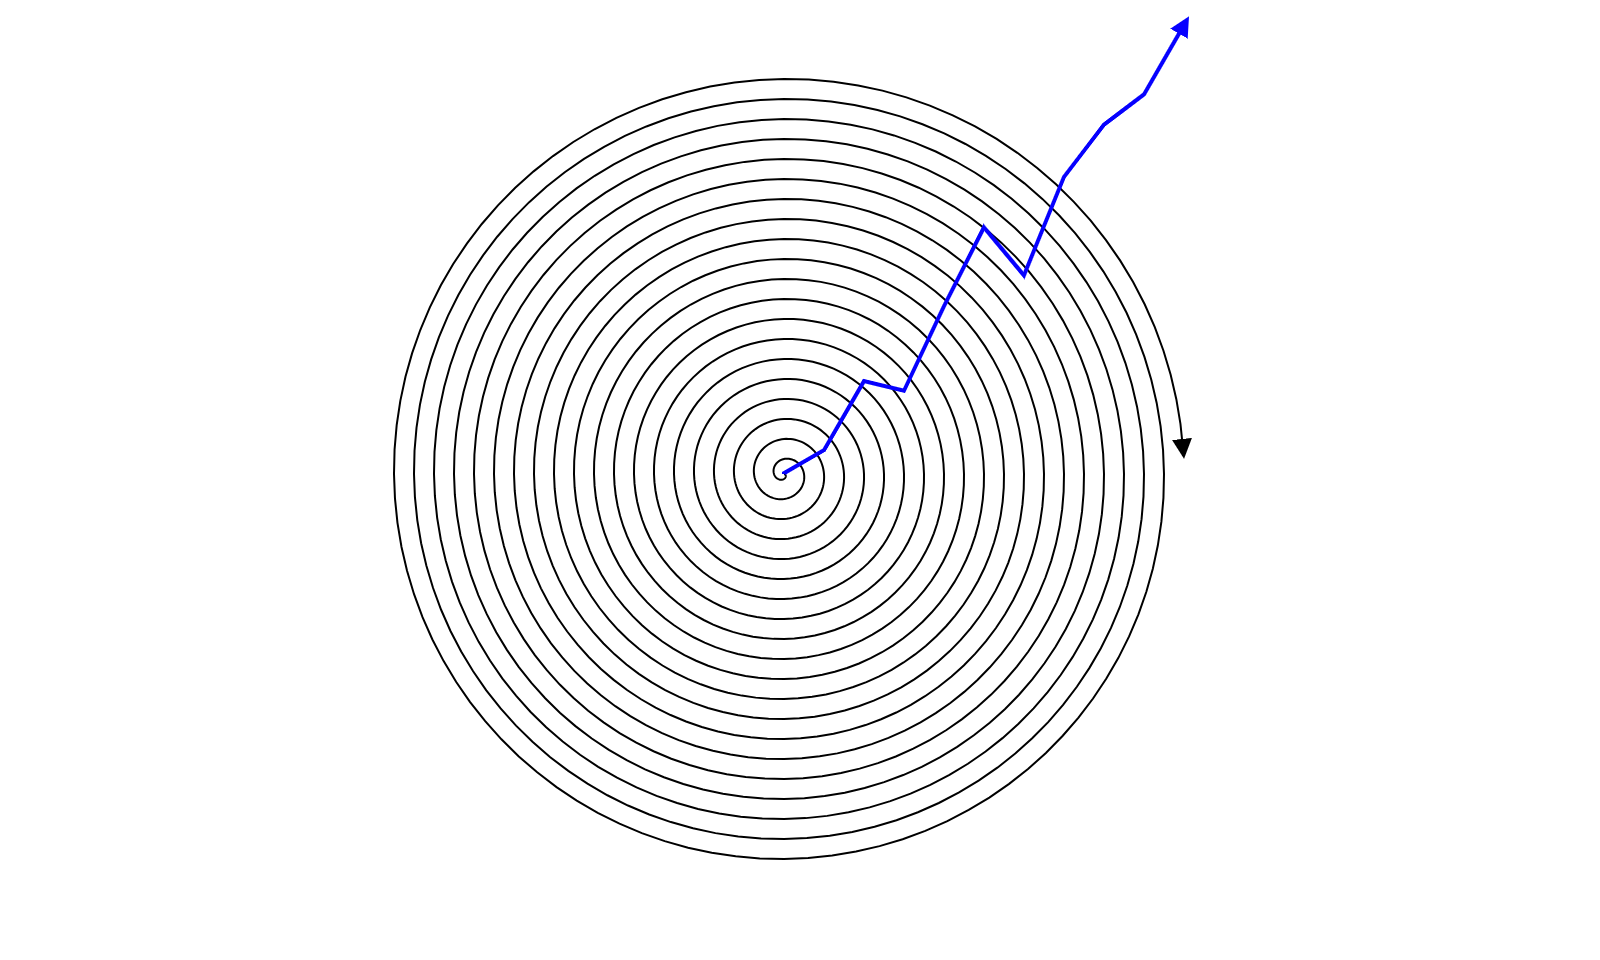
—— 这就是为什么我们学了那么久,练了那么多,可一到实战场合就卡壳的重要原因之一。
前面这两张示意图,一个螺旋线条和一个随机弯曲的线条,是我让 ChatGPT 帮我画的…… 想象一下,我用怎样的提示词才能让它画出这种东西?
—— 下一章会告诉你答案。
当我们学习第二语言的时候,主要困境来自于,我们并非存在于时时刻刻的实战环境之中,并且,我们已然成年,错过了很多应该自然而然走过来的螺旋曲线路径。并且,可以接触到的所有教材或者课程,随时随刻都实际上并不系统并不够用。
在我长大的年代里,这是完全没有任何办法解决的困境。我都过了五十岁了,才知道人家描述自身位置的时候,不是我以为的 “describe your location”, 而是他们人人都习以为常的 “describe your bearings” —— 在此之前,我一直都不知道在这么个常用的场景里 bearings 竟然有这个词义…… 比如,确定自己的位置,to take one's bearings;熟悉环境,to get rid of one's bearings;迷失方向,to lose one's bearings……
哪怕是仅仅一把螺丝刀 —— 多么常用的一个物品 —— 我也只知道它是 a screw driver,但凡想说仔细点,当场卡壳……
- handle 把手
- grip 把手/把手上为了能够抓牢而设计的纹理
- insulation 绝缘
- ferrule 把手上的橡皮包头
- shank/shaft 螺丝刀身
- tip 螺丝刀尖
- flathead/slotted tip 扁头螺丝刀尖
- Philip tip 十字花螺丝刀尖
- 工人师傅用的还有更多类型,Torx tip, Pozidriv tip, square/Robertson tip
- magnetic tip 磁性螺丝刀头
- bit holder/bits 可换头螺丝刀/螺丝刀头
实际上,这也的确超出任何一本教程或者任何一个语言教师的能力范围。一方面这样的教材或者课程会无限复杂…… 除此之外,还有另外一个尴尬:我们在母语中自然而然地学会的 “系统” 实际上包括大量我们自己已经用了很久却从未总结整理过的东西 —— 当然,这些重要且不可或缺的内容,总是任何一个 “系统” 正常运行的必要条件。
过往的二十多年时间里,我只读非虚构类(Non-fictions),至于小说,连母语中文和韩文的都不怎么读。我一直以为自己阅读能力足够,因为我看书的确很快…… 终于有一天,当我意识到自己的词汇量事实上并不系统,于是,想了想,选了本小说开始看…… 感觉瞬间被生词淹没 —— 我的语言知识果然是真的极不系统极不够用:
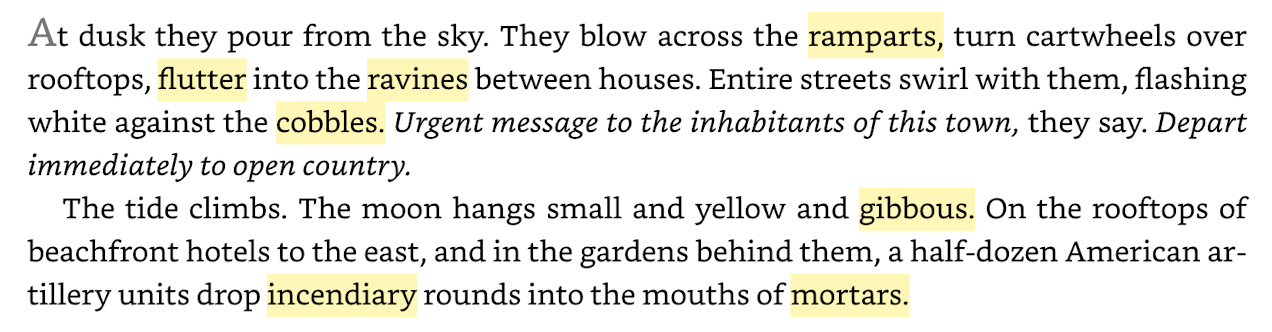
一本小说读下来,至少几百个生词…… 但,也值得,如此这般,只要几本下来,就真的 “至少系统够用” 了罢?
顺带说,要不是在一本小说里读到,我都不知道自己的发型竟然有专门的名称,是 mullet 的一种,叫做 ponytail mullet…… 这种词汇,自己去查汉英词典,都不知道该去查什么,又如何查得到?
我经常用在各处的另外一个例子是,虽然普通话对我们来说都是母语,可实际上,有很多的规则和细节,我们用了那么久也没总结归纳过,也没人教过我们。
我们说由两个三声的字构成的词的时候,比如,起始
[qǐ shǐ],水井[shuǐ jǐng],土壤[tǔ rǎng],美好[měi hǎo],展览[zhǎn lǎn]…… 等等,我们会不由自主地把第一个三声字说成二声,说出来的其实是,起始[qí shǐ],水井[shuí jǐng],土壤[tú rǎng],美好[méi hǎo],展览[zhán lǎn]……
99% 的人估计没注意到吧?没人教过,没在书里读过,反正一直就是这么用的…… 当然,我们不应该忘记自己最初是通过反复模仿他人才这么说的,因为人人都这么说。
当然,我们也可以想象,一个在美国工作的中文老师,会在课堂上认真讲解这条规则。并且,这样的总结归纳对学生也极其有用,是很好的辅助学习工具 —— 不是吗?
另外一个更微妙且有趣的例子是,汉字很有趣,有的象形,有的表音,有的表意,比如,在 “怒火攻心” 这四个之中,“火” 就是象形,“怒” 和 “攻” 即表音也表意。有趣的是,在汉字里,有两个表意字明显反过来了,或者说用错了,一个是 “重”,一个是 “出”。从表意的角度来看,“两座山叠在一起” 才是 “重”;“千里” 是很远的意思,“出门千里”…… 可偏偏,“千里 ⭢ 重”,读作 [zhòng];“两座山 ⭢ 出” 读作 [chū]…… 问问自己,用了那么久,有没有因为这个细节好奇过?99.999% 的人一辈子都没注意到吧?没注意到又如何呢?
然而,“没有注意到又如何” 是长期系统且够用地走螺旋式路径的结果。对外语学习者来说,这种优势和优越感并不存在,只能靠自己想办法。以前呢,咋想也没啥办法。现在呢?虽然人工智能的应用在很多领域依然有这样那样的不足,但,在语言学习或者语言教学方面,尤其是英语,人工智能几乎可以被认为完美无缺,完胜任何人类英语教师。
你跟它说:
Tell me names of parts of a screwdriver.
https://chatgpt.com/share/67105942-36cc-8009-9b40-76ae9d2d925e
它的回答实在是太详细、太系统。当然,你也可以问问它关于螺丝的各个部分的名称 —— 不妨自己试一试:
Tell me names of parts of a screw.
这是过往任何教师、任何教科书、任何教材教辅、任何词典、甚至任何搜索引擎都无法做到的事情。现在呢?有了人工智能之后,获得这样一个答案的成本几乎可以忽略不计 —— 你一天问成百上千这样的问题也不会话费超过 1 美元;24 小时随叫随到;并且,它总是可以给你最准确最全面最系统最够用的答案。
最后,值得重复强调的是,“永远尝试做到系统全面” 是个最重要的学习习惯,也是最佳学习实践。https://1000h.org 上的《重塑语音》教程其实篇幅很短,但,它也是个 “麻雀虽小五脏俱全” 的系统。能够把它完整掌握,就是建立这个重要习惯的极佳起点……
值得反复强调:
“密集” 且 “系统” 是任何练习真正有效的统一秘密。
只要你肯练,英语的 “异步处理”(读写)和 “及时处理”(听说)都可以 “不在话下” —— 只因为你有了人工智能,而它在这方面尤其好用。并且,真便宜啊!无法想象搞出一个 “专家水平的机器人团队”,每月的总体费用也就人民币 150 元左右 —— 人力成本无论如何都做不到如此低廉,与此同时,人力也无论如何都拼不过那些机器人,无论是时间、精力、态度,还是水平……
10.5. 写给家长的话#
在这里,值得多写几个段落,专门提醒家里还有小朋友正在上学的家长。
对所有人来说都一样,不分性别,不分智商高低,也不分家庭条件:
英语很可能是在小学阶段唯一可以彻底拉开距离的科目。
并且,英语能力也可能是未来最影响一个人收入水平的 “基础技能” 之一。在第五章里,我们提到:
突然之间,人群之间的贫富差距来源多了一项,一个看起来有多简单就实际上有多重要的选项:
能不能跟人工智能好好说话?
不用罗列更多的理由了吧?仅仅 “人工智能的母语只能是英语” 本身,就已经足够了吧?在不久的将来,“用自然语言编程” 全面落实的话,若是一个人能用英语直接与机器人高效沟通,那么,此人的效率一定相对更高,结果是什么呢?不用细说了吧?
过去,一个人的英语能力的差异主要受家庭条件影响,这是个非常令人遗憾的事实 —— 首先,请好的英语老师真的很贵,尤其是外教。再进一步,在很多地区,这干脆不是贵不贵的问题,那里完全没有好的英语老师,更别提外教了。突然之间,一切都不一样了,事实很清楚:没有任何人类老师在外语教学这个岗位上可以拼得过人工智能,所有的人类老师都只能降级为 “助教” ……
突然之间,所有人之间出现了 “教育资源绝对平等” —— 这真的是人类史上第一次。哪怕仅仅是 “英语教育资源绝对平等”,都已经足矣令人惊叹不已,不是吗?
语言练习,压根就不可能受性别和智商影响。最终只跟一个字有关系,“练”。练不练,差异很大。练的时候,“是否足够密集” 和 “是否足够系统” 是关键,而这些,若是与家庭条件有关系的话,现在肯定已经不是家庭经济问题,而是家长的观念问题 —— 家长没有这个认知,人工智能再聪明再便宜也帮不上啥忙。
反正都这样了,用不用呢?你自己决定。